
Indhold
Crawl budget er den mængde adresser, Google kan og vil hente på jeres site inden for en given periode. Når Google bruger tiden på sider, der ikke er værd at hente, tager det længere tid, før nye eller ændrede sider bliver fundet. Det er den del, der betyder noget.
For de fleste virksomheder er crawl budget ikke et problem. Google skriver selv, at det primært er noget, meget store sites skal tænke på. Men der er én type site, hvor det alligevel kan blive et problem: webshops med filtre. Her er, hvad crawl budget er, hvornår I skal bekymre jer, og hvad I gør, hvis I skal.
Kort fortalt
- Crawl budget er de adresser, Google kan og vil crawle. Det afhænger af, hvor meget jeres server kan klare, og hvor meget Google gerne vil hente.
- Google skriver, at det primært gælder sites med over en million sider eller over 10.000 sider, der ændrer sig dagligt. Tallene er et groft skøn.
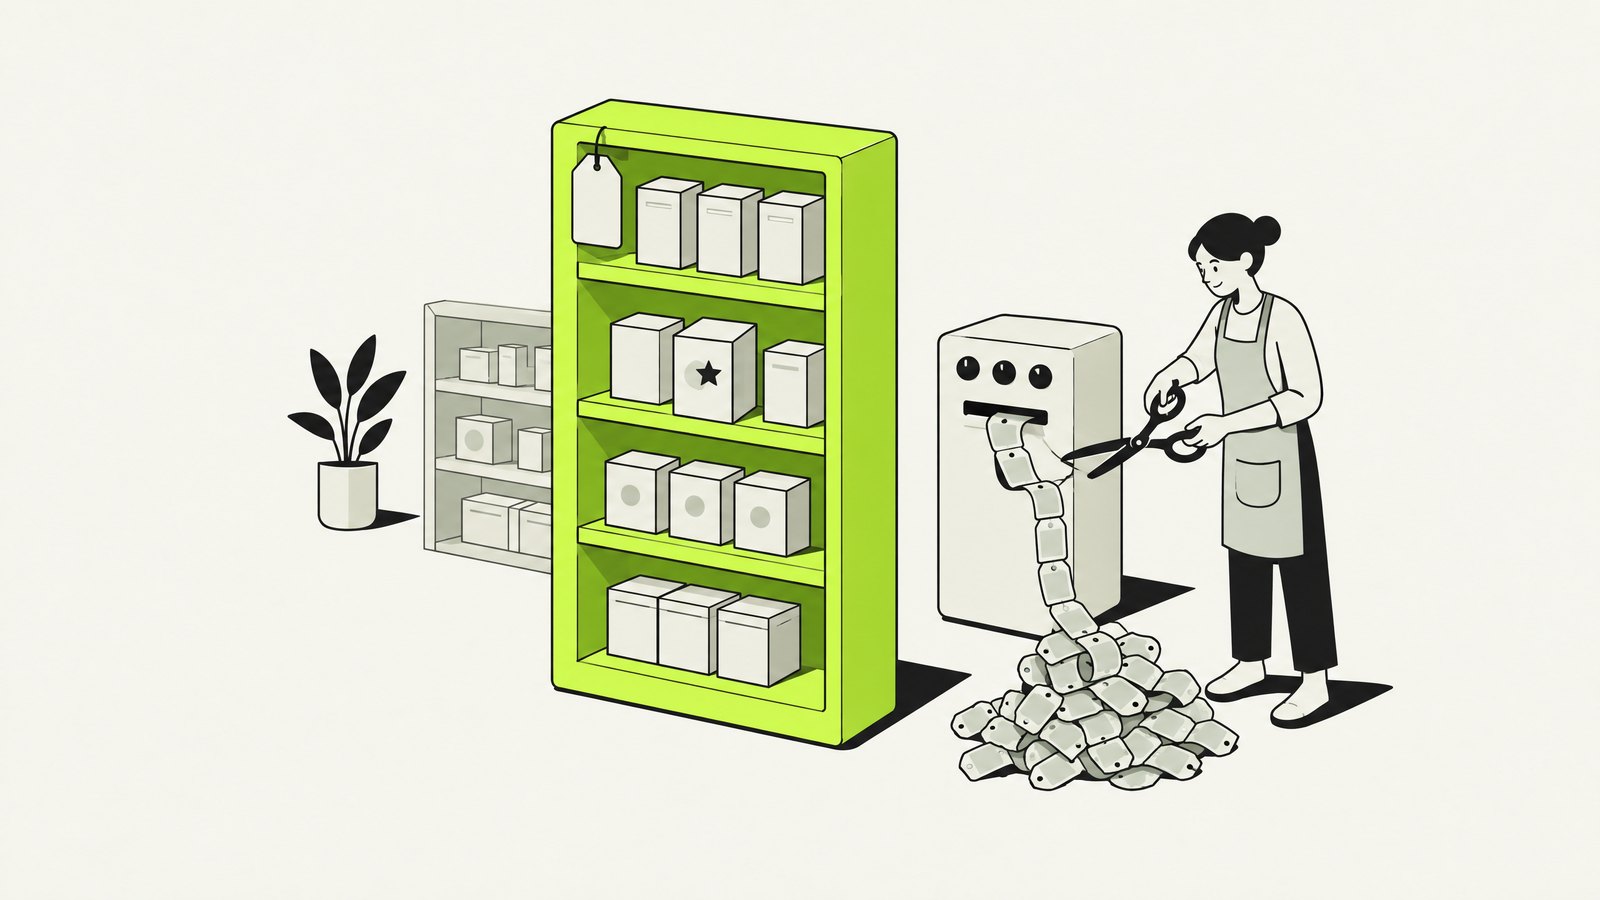
- En lille webshop kan alligevel få titusindvis af adresser, fordi filtre og sortering laver en ny adresse for hver kombination.
- Løsningen er sjældent at give Google mere tid. Det er at fjerne de adresser, der ikke skal crawles.
Hvad er crawl budget?
Googlebot har ikke uendelig tid til hvert site. Google beskriver crawl budget som to ting, der spiller sammen:
- Hvor meget serveren kan klare. Google crawler kun så hurtigt, som siden kan svare. Svarer den hurtigt og stabilt, crawler Google mere. Bliver den langsom eller svarer med fejl, bremser Google ned for ikke at overbelaste den.
- Hvor meget Google vil hente. Google prøver at crawle alle de adresser, den kender. Hvor ofte den kommer tilbage, afhænger af, hvor populære siderne er, hvor ofte de ændrer sig, og hvor gode de er.
Crawl budget er altså ikke et fast tal, I kan slå op. Det er det, Google kan og vil nå, og det bliver brugt på de adresser, Google kender, uanset om de er vigtige eller ej.
Hvornår betyder det noget?
Google skriver, at vejledningen er til tre slags sites:
- Store sites med over en million unikke sider, hvor indholdet ændrer sig cirka en gang om ugen.
- Mellemstore sites med over 10.000 unikke sider, hvor indholdet ændrer sig dagligt.
- Sites, hvor en stor del af adresserne står som “Registreret – endnu ikke indekseret” i Search Console.
Har I en hjemmeside med 50 eller 500 sider, er crawl budget næsten aldrig forklaringen på, at en side ikke bliver fundet. Så handler det oftere om, at siden ikke er linket internt, at den er blokeret, eller at Google ikke finder den værd at indeksere. Den slags finder I i indekseringen, ikke i crawl budget.
Det sidste punkt på Googles liste er det, der kan ramme en almindelig virksomhed. Antallet af sider, I selv har lavet, er ét tal. Antallet af adresser, Google har fundet, kan være et helt andet.
Hvorfor webshops med filtre er undtagelsen
En webshop med 300 produkter i 20 kategorier har måske 350 sider, I selv kender. Men hver kategori har filtre for farve, størrelse, mærke og pris, og hver kombination får sin egen adresse:
/kategori/sko/
/kategori/sko/?farve=sort
/kategori/sko/?farve=sort&stoerrelse=42
/kategori/sko/?stoerrelse=42&farve=sort
/kategori/sko/?farve=sort&stoerrelse=42&sortering=pris
Fem filtre med fem valg hver, plus fire måder at sortere på, giver tusindvis af adresser pr. kategori. De fleste viser de samme produkter i en anden rækkefølge, eller ingen produkter overhovedet. Google skriver om filtre, at de kan skabe et uendeligt antal adresser, og at Googlebot typisk henter rigtig mange af dem, før den kan se, at de ikke er værd at bruge tid på. Imens bliver nye produkter og ændrede priser fundet senere.
Andre kilder til ekstra adresser er:
- Sortering og visning.
?orderby=price,?visning=listeog antal pr. side. - Læg i kurv-links. I WooCommerce kan
?add-to-cart=stå som et almindeligt link, og hvert produkt får så en ekstra adresse. - Interne søgeresultater. Hver søgning på sitet er en ny adresse, hvis resultaterne kan crawles.
- Tracking-parametre. UTM-parametre på interne links giver en ny adresse for samme side. Det er et af de problemer, en god URL-struktur undgår.
- Kalendere og uendelig paginering. En kalender, hvor man kan klikke en måned frem i det uendelige, er en adresse uden ende.
Sådan ser I, om I har et problem
I Search Console er der to steder at kigge:
- Sideindeksering. Står der mange adresser som “Registreret – endnu ikke indekseret”, eller mange med parametre, I ikke kender, har Google fundet flere adresser, end I har sider. Klik på grunden, og se eksemplerne.
- Crawlstatistik. Under Indstillinger kan I se, hvor mange forespørgsler Google laver om dagen, hvor hurtigt serveren svarer, og hvilke typer filer og svarkoder der bliver hentet. Stiger svartiden, eller er en stor del af forespørgslerne til adresser med parametre, er det et tegn.
Sammenlign tallene med det, I selv har. Har I 400 sider, og Google kender 40.000 adresser, er det de 39.600, I skal se på.
Sådan sparer I på crawl budget
1. Bloker de adresser, der aldrig skal crawles
Filtre, sortering, læg i kurv-links og interne søgninger, der ikke skal findes i Google, blokerer I i robots.txt. Google anbefaler det som den mest effektive løsning for filtre, der ikke skal indekseres. Et eksempel:
User-agent: *
Disallow: /*?*orderby=
Disallow: /*?*add-to-cart=
Disallow: /*?*farve=
Disallow: /*?s=
Test reglerne, før I lægger dem op. En regel, der er for bred, kan blokere de kategorisider, I gerne vil findes på. Er der et filter, der svarer på en rigtig søgning, fx “sorte løbesko”, så lad det være crawlbart og giv det en fast adresse, en overskrift og en tekst, så det bliver en side i sig selv.
2. Brug ikke noindex for at spare crawl
Noindex holder en side ude af Google, men Google skal stadig hente siden for at se mærket. Google skriver direkte, at noindex ikke sparer crawl budget. Brug noindex til sider, der skal kunne besøges, men ikke vises i søgeresultaterne, og robots.txt til adresser, Google slet ikke skal hente.
3. Saml dubletter
Varianter af samme produkt, adresser med og uden skråstreg og http og https er duplicate content, der får Google til at hente det samme flere gange. Saml dem med omdirigeringer, hvor det er muligt, og canonical-tags, hvor varianterne skal blive. Canonical virker langsommere end robots.txt, fordi Google stadig crawler varianterne, men den samler signalerne på den rigtige side.
4. Lad fjernede sider give 404 eller 410
Udsolgte produkter, der aldrig kommer igen, og sider, I har slettet, skal svare med 404 eller 410. Google skriver, at en 404 er et stærkt signal om ikke at crawle adressen igen. Sider, der siger “ingen produkter fundet”, men svarer med 200, kalder Google soft 404, og dem bliver Google ved med at hente. Det samme gælder filterkombinationer uden resultater.
5. Undgå kæder af omdirigeringer
Peger en adresse videre til en adresse, der peger videre igen, skal Google hente flere adresser for at nå frem. Ret de interne links, så de peger direkte på den endelige adresse.
6. Hold sitemap og interne links rene
Jeres XML-sitemap skal kun indeholde de sider, I vil have indekseret, med en korrekt dato for sidste ændring. Interne links skal pege på de rigtige adresser, ikke på filtrerede eller sorterede varianter.
7. Gør serveren hurtig
Jo hurtigere serveren svarer, jo flere sider kan Google hente uden at bremse. Det handler om svartiden fra serveren, ikke kun om, hvordan siden føles for den besøgende. Billig delt hosting og et tungt tema er typiske årsager til, at en webshop svarer langsomt.
Det skal I ikke gøre
- Bloker ikke sider midlertidigt i robots.txt for at flytte crawl til andre sider. Google skriver, at det kun hjælper, hvis Google allerede rammer jeres servers grænse, og blokerede adresser bliver i køen længere end adresser, der giver 404.
- Bloker ikke CSS og JavaScript, som Google skal bruge for at forstå siden.
- Regn ikke med at kunne bestille mere. I kan ikke købe eller bede om mere crawl budget. I kan kun gøre det lettere for Google at bruge det rigtigt.
Sådan arbejder vi
Når vi laver en teknisk SEO-gennemgang af en webshop, sammenligner vi de sider, butikken har, med de adresser, Google har fundet. Er forskellen stor, finder vi ud af, hvor de ekstra adresser kommer fra, og hvilke filtre der faktisk har søgninger. Resten bliver blokeret, samlet eller fjernet, så Google bruger tiden på de sider, der sælger.
Ofte stillede spørgsmål
Hvad er crawl budget?
Den mængde adresser, Google kan og vil hente på et site. Det afhænger af, hvor meget serveren kan klare, og hvor stor interesse Google har for siderne.
Har vi brug for at tænke på crawl budget?
Sandsynligvis ikke, hvis I har en almindelig hjemmeside med nogle hundrede sider. Det bliver relevant, når sitet har mange tusinde adresser, typisk på grund af filtre på en webshop, eller når mange sider står som registreret, men ikke indekseret.
Hvordan ser man sit crawl budget?
Der er intet tal for det. I Search Console kan I under Indstillinger se crawlstatistikken med antal forespørgsler, svartid og svarkoder, og i sideindekseringen, hvilke adresser Google har fundet.
Sparer noindex crawl budget?
Nej. Google skal hente siden for at se noindex. Skal en adresse ikke crawles, så bloker den i robots.txt eller fjern den.
Skal filtersider på en webshop indekseres?
Kun dem, der svarer på en rigtig søgning, som “sorte løbesko”. Giv dem en fast adresse og eget indhold. De øvrige kombinationer bør blokeres, så Google ikke bruger tid på dem.
Kilder
- Google Search Central, Crawl budget management for large sites, developers.google.com.
- Google Search Central, Managing crawling of faceted navigation URLs, developers.google.com.
- Search Console Help, Crawl Stats report, support.google.com.